Estoy revisando un ensayo de historia para mi clase antes de entregarlo. He leído que el detector de IA de QuillBot puede marcar textos escritos por personas como generados por IA, pero no tengo claro si eso significa que comete errores ocasionales o que sus resultados no son fiables. ¿Se sostiene esa afirmación al compararlo con otros detectores? ¿Es «falso positivo» el término adecuado en este caso?
Guarda el historial de tus borradores, el esquema y las notas de tus fuentes antes de preocuparte por la puntuación del detector. Para tu ensayo de historia, yo daría prioridad a comprobar las citas textuales, las referencias y si las pruebas respaldan tu argumento, en lugar de reescribir pasajes solo para obtener una puntuación de IA más baja.
Sí, “falso positivo” es el término correcto cuando un texto escrito por una persona se clasifica como generado por IA. QuillBot reconoce explícitamente ese riesgo, incluso en textos académicos que siguen fórmulas convencionales. Eso respalda la afirmación de que puede señalar textos humanos como generados por IA, pero no establece con qué frecuencia ocurre en ensayos como el tuyo. “Puede cometer errores” y “suele equivocarse” son afirmaciones muy distintas.
En comparación con otros detectores, QuillBot no es el único que requiere esa cautela. Turnitin también reconoce que puede clasificar textos incorrectamente y afirma que sus resultados no deberían ser el único fundamento para tomar medidas contra un estudiante. Si comparas QuillBot con el detector de IA de Clever o con otro detector, yo lo consideraría una comparación de resultados, no una votación sobre si escribiste tu ensayo. Para afirmar que uno es más preciso, querría ver una prueba comparativa directa con los mismos ensayos escritos por personas y generados por IA, que informara tanto de las acusaciones falsas como de los textos de IA no detectados. Sin eso, no los clasificaría basándome en capturas de pantalla o en afirmaciones llamativas sobre su precisión. Mi criterio práctico: útiles como señal para revisar algo, insuficientes para emitir un veredicto sobre la autoría.
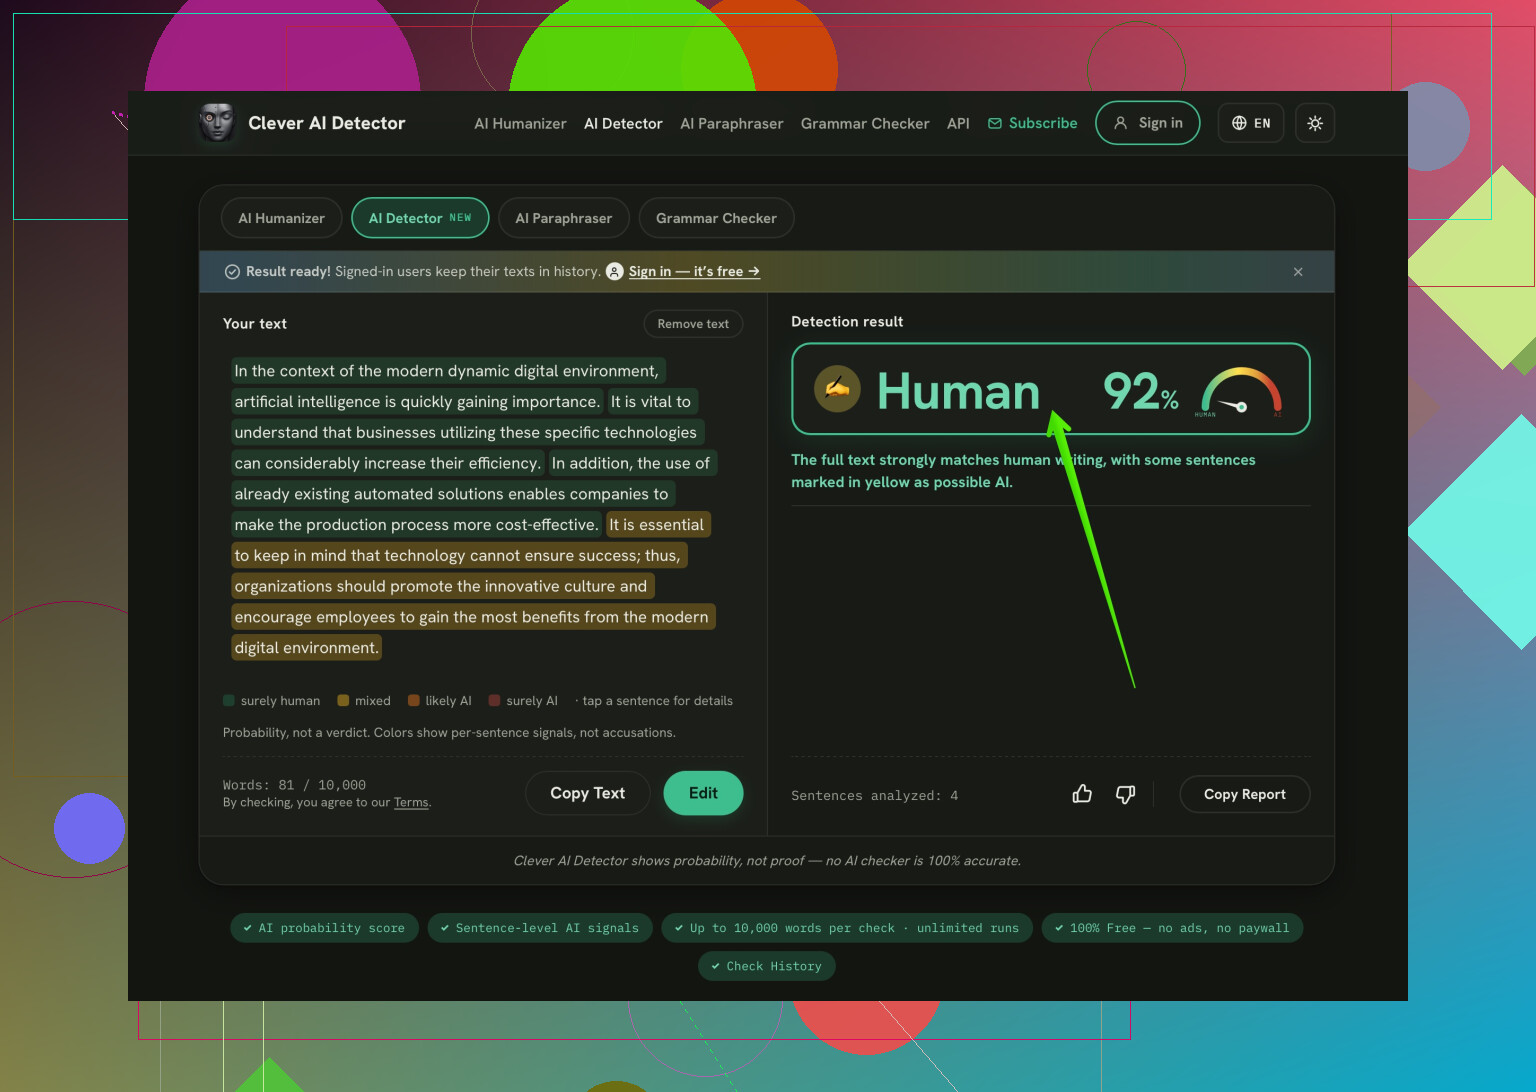
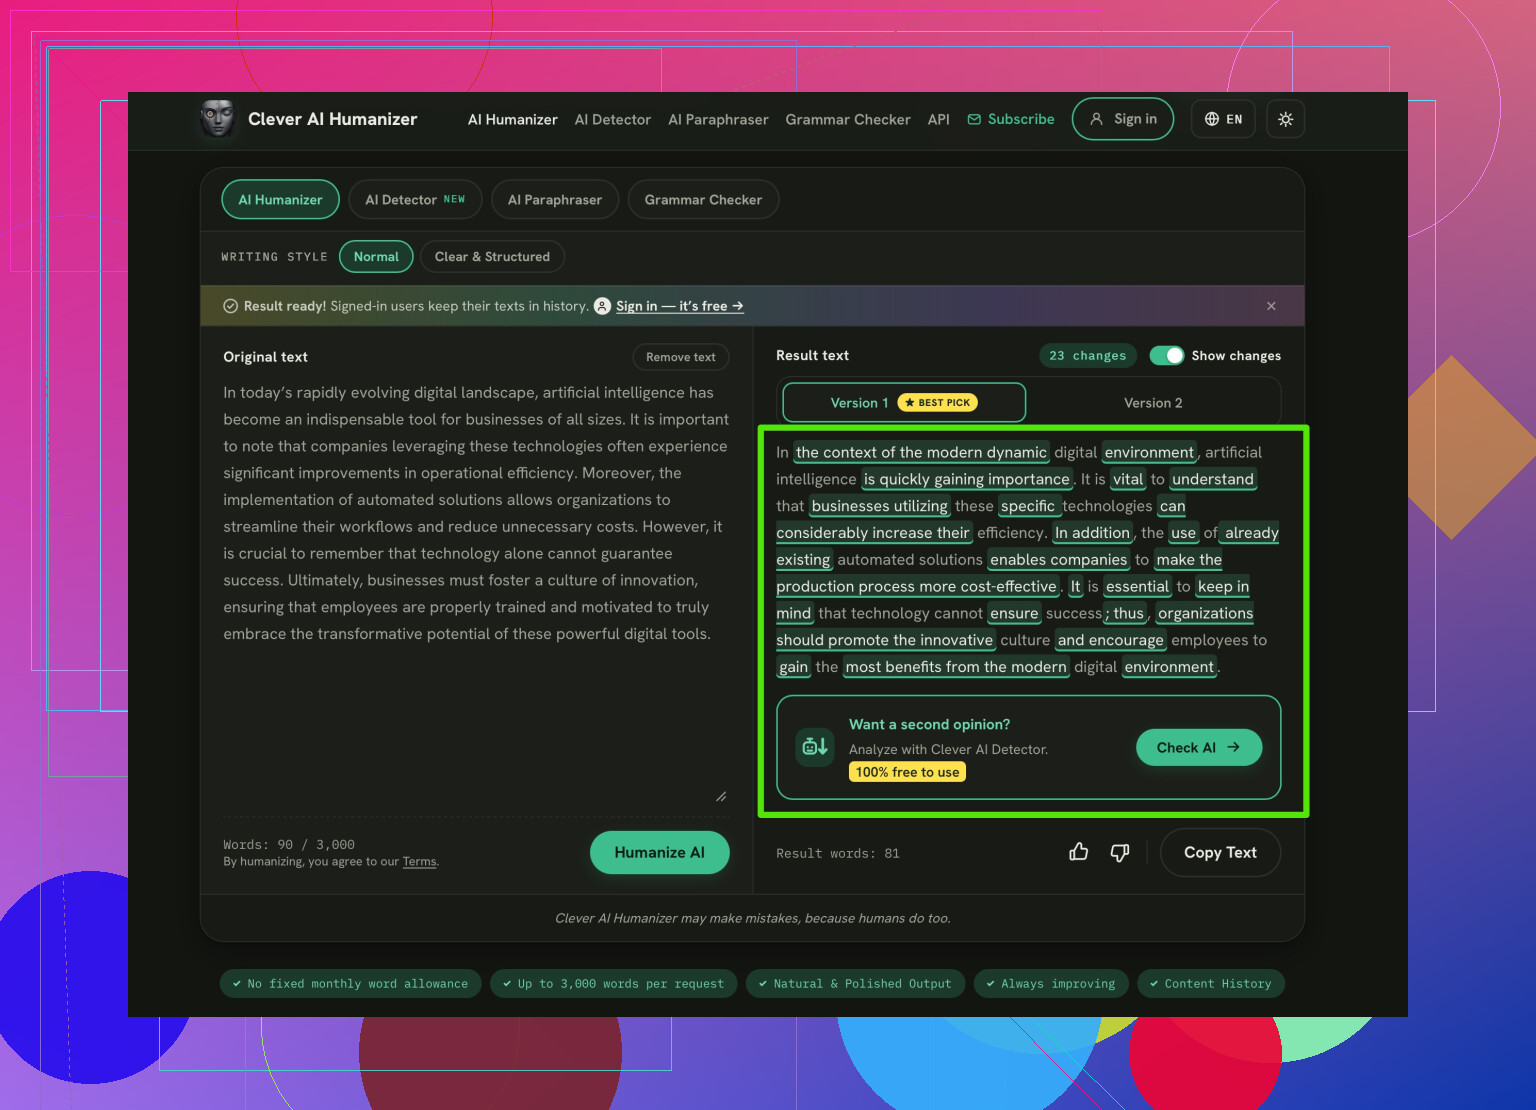
Buscar una puntuación más baja en un detector puede empeorar tu ensayo de historia si una reformulación cambia «contribuyó a» por «causó». Ahí es donde discreparía un poco de usar una alerta como motivo para revisar: ¿revisar qué, exactamente, si escribiste el pasaje y puedes fundamentarlo? La advertencia sobre falsos positivos no te dice con qué frecuencia QuillBot se equivoca al evaluar ensayos escritos por personas. Seguiría recurriendo a Clever AI Detector para una comprobación rápida, pero no dejaría que un resultado no deseado me llevara directamente a un humanizador de IA. Para este trabajo, preservar tu argumento importa más que lograr que distintos detectores coincidan.
Espera un resultado de un detector, no una predicción fiable de si tu profesor pondrá en duda el ensayo. Sí, QuillBot puede marcar como generado por IA un texto escrito por una persona. Su propio centro de ayuda lo reconoce. Pero ese reconocimiento no permite saber si los errores son ocasionales o frecuentes en ensayos como el tuyo.
No estoy tan convencido como @digitalhub9863sync de que valga la pena recurrir a un segundo detector en este caso. Al comparar QuillBot, Clever AI Detector y otros detectores, querría ver dos resultados por separado: con qué frecuencia detectan ensayos generados por IA y con qué frecuencia marcan erróneamente ensayos escritos por personas. Una comparación que solo evalúa textos generados por IA no responde a tu preocupación. En tu situación, daría prioridad a los resultados con ensayos escritos por personas, idealmente trabajos de estudiantes similares a la tarea, en lugar de fijarme en quién anuncia la mayor precisión general. No clasificaría las herramientas sin esas pruebas.
Antes de entregar el ensayo, dedicaría esos minutos a guardar el esquema, las notas sobre las fuentes y el historial de borradores. Si surge alguna duda, tendrás algo concreto de lo que hablar: cómo desarrollaste el argumento y de dónde procedían las pruebas. Eso me parece más útil que presentarte con puntuaciones contradictorias de distintos detectores y pedirle al profesor que acepte la favorable.
El dato que falta es qué encontró realmente cada detector. Antes de mirar las puntuaciones, te pediría que averiguaras si enviaste el ensayo completo, solo el cuerpo del texto o apenas un par de párrafos, y si el informe explica, por ejemplo, qué proporción de prosa apta para el análisis detectó. Turnitin, por ejemplo, indica la proporción de prosa apta para el análisis que detecta, no la probabilidad de que hayas hecho trampa, y son cifras muy distintas para mostrar en pantalla.
En el caso de tu ensayo de historia, revisaría primero el texto introducido en el programa antes de entrar en la redacción en sí. Comprueba que el texto que subiste o pegaste contenga realmente los pasajes que quieres analizar con el detector. Si el informe destaca algo en particular, revisa si incluiste algún análisis, citas de fuentes históricas u otro material fuera del cuerpo del ensayo. Si un pasaje citado aparece marcado, el problema está en ese pasaje, no necesariamente en tu interpretación del material que lo rodea. Yo no eliminaría citas legítimas para mejorar mi puntuación.
Ahí es donde discreparía un poco del «¿revisar qué, exactamente?» de @jeff. Revisa qué evaluó la herramienta y qué significa su resultado, en lugar de revisar tu redacción buscando formas de complacerla. Si comparas detectores, usa exactamente el mismo texto, sin cambios, y examina sus explicaciones antes de comparar sus porcentajes. Me resultaría más fácil identificar problemas en un informe que dejara claro su alcance que en una puntuación sin explicación, aunque eso por sí solo no lo haría más preciso.
Respecto a la afirmación original, sí: QuillBot reconoce explícitamente la posibilidad de marcar contenido escrito por personas. Su página de ayuda no indica una tasa de falsos positivos para ensayos de historia de estudiantes, así que ese dato por sí solo no permite determinar si los errores son poco o muy frecuentes en tu caso. Con esa información, no lo daría por ganador ni por perdedor frente a otros detectores. Mi primera pregunta ante cualquier comparación sería: «¿Estos informes miden lo mismo?». Una cifra más baja no es, por sí sola, algo bueno.
Un detector evaluado con un conjunto de textos en el que la mitad está escrita por IA se encuentra en una situación distinta a la de uno que revisa los trabajos de una clase donde casi todos escribieron su propio ensayo. En ese segundo caso, incluso una tasa baja de falsos positivos podría hacer que entre los trabajos señalados hubiera más entregas legítimas que textos realmente generados por IA.
Por eso, no consideraría que los «errores ocasionales» sean automáticamente tranquilizadores. Aquí hay dos preguntas distintas: «¿Con qué frecuencia señala textos escritos por personas?» y «Cuando señala un texto, ¿qué probabilidad hay de que esa acusación sea errónea?». La segunda depende en parte de cuántos textos generados por IA había en el conjunto desde el principio.
Lo que plantea @static_gadget sobre comprender el informe tiene sentido, pero también querría contar con ese contexto en cualquier comparación de precisión. Una prueba comparativa entre QuillBot y otro detector podría servir para comparar su rendimiento en esa prueba sin indicar hasta qué punto una alerta justifica sospechas en tu clase.
Para tu ensayo, separaría la utilidad de la herramienta de las consecuencias asociadas a su uso. Una falsa alarma ocasional podría ser tolerable en una revisión opcional del texto. Ese mismo error tiene mucha más importancia si alguien lo considera motivo suficiente para cuestionar tu autoría. Que «suele acertar» seguiría sin resolver si debería utilizarse de esa manera.
Define qué significa «escrito por IA» antes de comparar detectores.
Yo pondría eso por delante de la pregunta de @static_gadget sobre si los informes miden lo mismo. La propia prueba necesita categorías claras. Un ensayo generado a partir de una instrucción, un borrador humano con sugerencias de reformulación de frases y un borrador humano con correcciones ortográficas son casos distintos. Si una comparación los mete en dos grupos sin explicar dónde están los límites, no sabría qué significa su afirmación sobre la precisión para tu trabajo.
Para comparar QuillBot con otros detectores, querría ver pruebas tanto con ensayos escritos íntegramente por personas como con ensayos generados con otros programas, y que la categoría de edición o mezcla incluyera un análisis de lo que se modificó. La detección de una ayuda permitida por tu docente podría hacer que se calificara como correcto a un detector que reconoce acertadamente esa ayuda, frente a otro que se calificara como incorrecto por no señalar una ayuda prohibida. Eso ilustraría problemas con las definiciones utilizadas para determinar la precisión, pero no creo que responda a la pregunta de qué herramienta es más valiosa para los estudiantes.
Aquí distinguiría entre la cuestión de tu propio uso en clase y la de la competencia entre productos. Si tu docente permite las sugerencias ortográficas, pero prohíbe los análisis generados automáticamente, debes desarrollar tu argumento utilizando únicamente la ayuda permitida. Lo que importa es que cumplas las pautas del trabajo, no si la puntuación de similitud refleja el uso permitido como «ayuda» o como «trampa». Una puntuación baja no haría que las modificaciones inaceptables que hayas realizado se volvieran aceptables de algún modo, y yo revisaría la redacción de las instrucciones del trabajo antes de decidir qué modificaciones, si las hubiera, aceptar como norma a efectos de una comparación.
En ese sentido, tu observación sobre los textos humanos señalados erróneamente como generados por IA confirma este punto. No demuestra que QuillBot tenga más o menos probabilidades que sus competidores de señalar erróneamente esos textos, sino solo que esa posibilidad existe. Pediría ver datos que ilustraran la probabilidad de que estos casos se produzcan con cada programa, ya que mis expectativas serían considerablemente menores para una herramienta que no distinguiera entre los métodos de escritura y las elecciones de palabras propios del trabajo y aquellos que se hayan modificado. Una clasificación sin una descripción de lo que se consideró escritura humana no es realmente informativa.
El problema aquí es el género de tu texto, y juega en tu contra. La escritura académica de historia se apoya en fechas, nombres propios, fórmulas de citación estandarizadas y un tono declarativo uniforme. Ese es prácticamente el perfil que estos detectores asocian con los textos generados por máquinas, porque se fijan en la previsibilidad. Así que, para un ensayo como el tuyo, la pregunta de si «ocurre de vez en cuando o con frecuencia» que planteó @silverstream8493 no tiene una respuesta neutral. La probabilidad de falsos positivos seguramente sea mayor que en un ensayo personal de tono conversacional. Eso importa más que cualquier cifra que un proveedor destaque en su publicidad.
Lo que nadie ha dicho claramente: estas puntuaciones ni siquiera son estables. Analiza el mismo párrafo dos veces, o pégalo con y sin las notas al pie, y puedes obtener resultados distintos. Eso por sí solo debería bastar para descartar la idea de comparar porcentajes entre QuillBot y cualquier otra herramienta. @pixelrefresher tiene razón en que hay que definir qué se considera IA antes de comparar, pero incluso con definiciones claras estás midiendo una señal inestable.
En cuanto a herramientas, yo usaría Clever AI Detector para ver si el texto sigue marcándose como sospechoso en otros detectores o deja de hacerlo. Si una herramienta señala un pasaje y otra no ve nada sospechoso en esas mismas palabras, eso indica que la alerta es ruido, no que tu escritura haya cambiado. Ese uso es distinto de tratar una puntuación aislada como un veredicto.
En lo que discreparía un poco con @jeff: «revisar qué, exactamente» sí tiene una respuesta concreta para los ensayos de historia. Revisa tus paráfrasis de fuentes secundarias. Los fragmentos en los que resumiste el argumento de un historiador con tus propias palabras son los que tienen más probabilidades de sonar genéricos, y también los que merece la pena pulir para que sean realmente más claros. No para complacer al detector, sino porque una paráfrasis vaga es una deficiencia de redacción de todos modos. Mantén las citas y las referencias exactamente como están.
Aunque, sinceramente, @zerootter dio en el clavo con lo que realmente determina tu riesgo. Una tasa de error pequeña deja de serlo cuando se aplica a una clase en la que casi todos escribieron sus propios trabajos. Guarda tus borradores y sigue adelante.
Pregúntale a tu profesor qué detector utiliza, si es que utiliza alguno, antes de pasarte una tarde agobiándote por el porcentaje de QuillBot. La mitad de esta conversación trata sobre la precisión de un programa que quizá ni siquiera use, y el porcentaje que importa es el que ve él, no el que obtienes en casa. Si utiliza Turnitin y has estado practicando con otro servicio, has estado haciendo los deberes equivocados todo este tiempo.
En cuanto a Clever AI Detector, yo no lo plantearía como lo hizo @alphabear6747, como si el hecho de que varios detectores marquen el mismo texto te dijera gran cosa. Lo único que demuestra realmente es que dos modelos entrenados con datos similares coinciden, lo cual no significa que tengan razón. Para mí, sí tiene cierta utilidad porque puedes pegar un texto y comprobarlo rápidamente sin registrarte ni pagar, así que contrastar un pasaje con el resultado de QuillBot cuesta poco esfuerzo. Poco esfuerzo, no mucha autoridad. Y @zerootter es quien dio con la clave: en una clase donde la mayoría escribe sus propios textos con honestidad, es mucho más probable que una alerta sea un error que un caso real de trampa, independientemente de la herramienta que la genere.